技术分享 · 原始报告日期:2026-05-28
给定一组不同视角的照片,怎样重建一个可以自由切换视角、实时渲染的三维场景?
3D Gaussian Splatting(3DGS)用一组带有位置、形状、颜色与不透明度的三维高斯表示场景。渲染时,将它们投影成屏幕上的软椭圆,再按照遮挡关系合成像素;训练时,把图像误差沿着这条链路反向传回高斯参数。
本文由我的 87 页组会报告整理,合并了重复目录和补充讲解,将公式、代码和图示放到同一条阅读主线上。前半部分解释原始 3DGS,后半部分梳理报告涉及的几何、语言、编辑与生成扩展。论文示例保留出处,不作为个人复现实验结果。
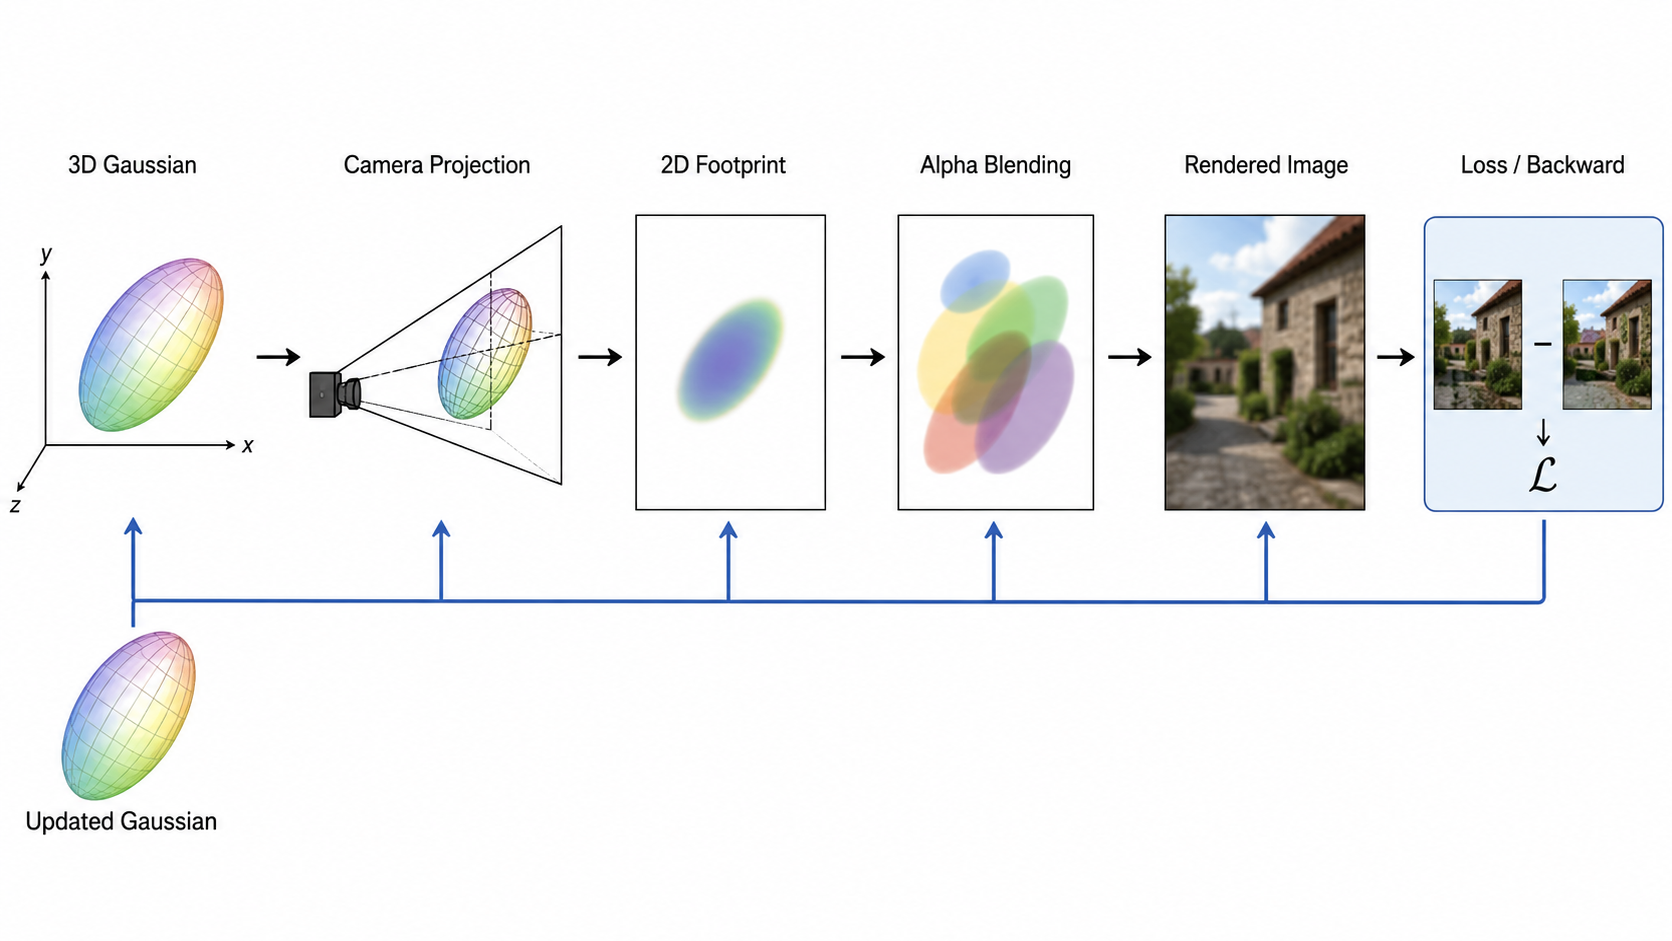
图 1:原报告第 5 页的教学示意图,原页标注为 Generated teaching diagram。
先把任务、表示与渲染分开
经典新视角合成的输入通常包括:
- 同一静态场景的多视角图像。
- 每幅图像对应的相机内参和位姿。
- 可用于初始化的稀疏三维点,例如 SfM 的输出。
原始 3DGS 针对一个场景优化一组高斯。优化完成后,输入新的相机位姿,渲染器就可以生成该视角的图像。后续前馈方法会训练一个跨场景网络直接预测高斯,两者的训练方式需要区分。
| 表示路线 | 主要保存什么 | 典型渲染思路 |
|---|---|---|
| 三角网格 | 顶点、面、材质 | 投影三角形并计算像素着色 |
| NeRF | 空间位置与方向到密度、颜色的映射 | 沿相机射线采样并进行体渲染 |
| 点云 | 离散三维位置及附加属性 | 点投影,需要进一步处理覆盖与空洞 |
| 3DGS | 具有体积形状和外观的显式高斯 | 投影软椭圆并按深度混合 |
NeRF 的辐射场常写成:
3DGS 也表达空间外观与视角相关颜色,但将场景参数显式放在高斯基元上。它不是简单地把每个点画成一个固定大小的圆:高斯的三维协方差及相机投影共同决定屏幕覆盖范围。
一个高斯到底保存哪些参数
用下面的参数集合表示第 个高斯:
| 参数 | 含义 | 影响 |
|---|---|---|
| 三维中心 | 位置和投影中心 | |
| 三个尺度 | 长短轴和覆盖范围 | |
| 旋转四元数 | 椭球朝向 | |
| 基元不透明度 | 对背景及后方高斯的遮挡 | |
| 球谐系数 | 随观察方向变化的颜色 |
球谐函数把方向相关颜色写成有限基函数的组合:
每个系数可以含 RGB 三个分量。只有零阶时,颜色不随方向改变;加入高阶项后可以表达更丰富的方向变化。实际实现还可能包含颜色偏置与非负裁剪。
高斯权重不是颜色,也不一定是概率密度
三维影响权重可写为:
中心处取 1,远离中心后衰减,衰减方向由协方差决定。这里省略了概率密度的归一化系数,因此不应要求其空间积分等于 1。
如果讨论严格的三维高斯概率密度,还需要乘上:
原报告补充页中的概率密度推导,可以帮助理解椭球形状;渲染中的权重与透明度组合则承担不同的建模作用。
为什么把协方差拆成旋转和尺度
直接优化一个任意的 3×3 矩阵,可能使它不再是合法协方差。使用:
就能用正尺度和旋转构造协方差。这里的 是未约束的对数尺度;四元数归一化后再转为 。
从单位球出发,先沿三个轴伸缩,再旋转,就得到一个各向异性的椭球。严格正尺度给出正定协方差;当某个尺度趋近零时,会接近退化情形。
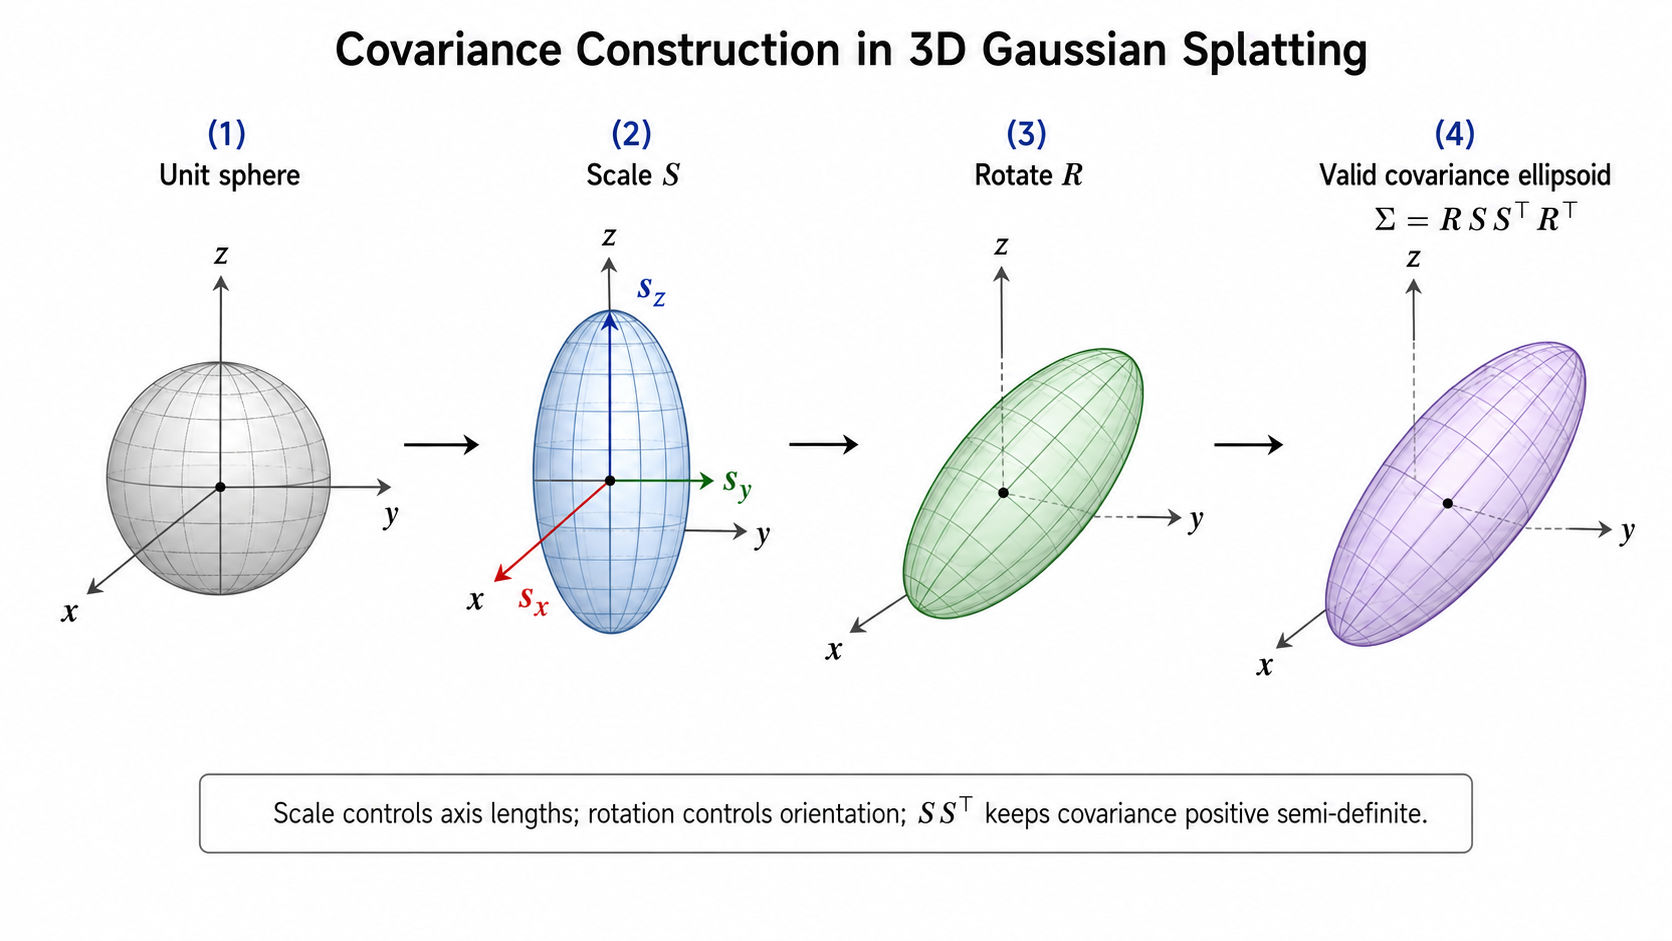
图 2:原报告第 25 页,生成式教学示意图。图中的 S 表示正尺度矩阵。
从世界坐标到屏幕:中心与协方差要一起变换
这一节采用“世界到相机”的外参约定。 将世界坐标转换到相机坐标,不能与相机到世界的位姿矩阵混用。
第一步:世界空间到相机空间
对于中心和协方差:
平移改变中心,不改变高斯内部相对位移的协方差;旋转则同时改变中心与椭球朝向。
第二步:透视投影中心
记相机空间中心为 ,使用无畸变针孔相机模型:
可以将过程分成四种坐标:世界坐标、相机坐标、除以深度后的归一化坐标,以及应用焦距和主点后的像素坐标。
这里要求中心位于可处理的相机前方。实际渲染器还要做近裁剪、视锥剔除和数值稳定处理。
第三步:用局部线性化投影协方差
透视除法是非线性变换。不能把一个 3×3 协方差矩阵直接当作 2D 椭圆,也不能假定非线性投影后的分布仍是精确高斯。
在中心附近进行一阶近似,其雅可比为:
投影协方差近似为:
如果从世界空间直接写:
由此得到屏幕上的椭圆 Footprint:
- 决定椭圆中心。
- 协方差特征向量决定主轴方向。
- 特征值决定沿主轴的扩展程度。
- 深度和相机焦距会改变其屏幕大小。
实际实现可能对屏幕协方差增加滤波项,以避免过小的高斯漏采样或数值不稳定。这属于光栅化细节,不改变上述主线。
从软椭圆到像素贡献
对屏幕像素 ,第 个高斯的二维权重为:
定义像素级 Alpha:
这里专门用 表示基元不透明度,用 表示像素处的有效 Alpha,避免把两个含义都写成同一个 。
一个高斯不会对覆盖范围内的所有像素产生相同作用。越靠近中心,权重越大;沿长轴衰减慢,沿短轴衰减快。
Alpha Blending:颜色贡献还取决于前方遮挡
假设当前像素对应的高斯已经按从前到后排序。到达第 个高斯之前的剩余透射率为:
包含背景项的颜色合成为:
其中:
每项贡献同时包含三个因素:前方剩余透射率、自身 Alpha、颜色。前面越不透明,留给后面的颜色权重越少。
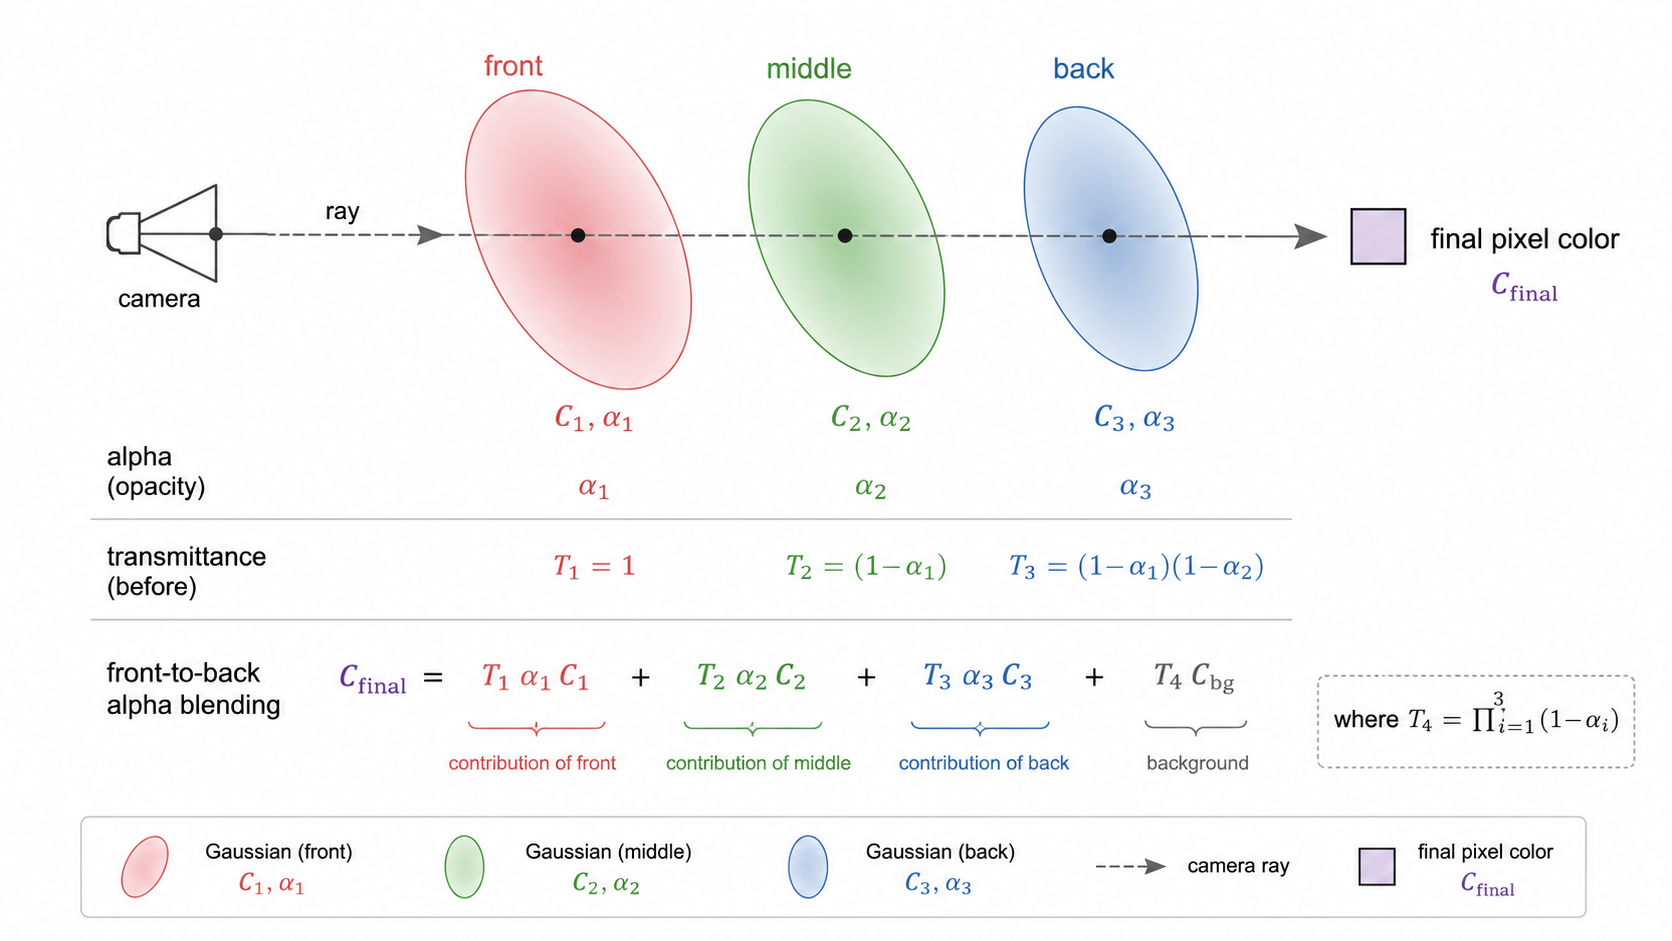
图 3:原报告第 16 页,生成式教学示意图。图中 alpha 对应本文的像素级 a。
可以补一个便于手算的例子。设前方红色高斯的 Alpha 为 0.6,后方蓝色高斯为 0.5:
也就是红色权重 0.6、蓝色权重 0.2、背景权重 0.2。把前后顺序交换后,结果通常改变,因此不能用不考虑顺序的普通加法替代混合。
图像误差如何更新三维参数
渲染得到预测图像 ,与真实图像 计算损失。原始方法结合像素 L1 与结构相似性损失:
原始论文使用 。训练会从不同相机视角采样图像,对同一组场景高斯进行优化。
只看位置参数的一条依赖链,可以写成:
反向传播沿这条链计算梯度,使高斯向能降低图像误差的位置移动。尺度、旋转、不透明度和球谐系数也通过各自的依赖路径被更新。
“可微渲染”主要描述这些连续计算。剔除、排序、Tile 分配以及增删高斯包含离散选择,并不是每一个工程步骤都处处光滑。
用一个二维高斯理解优化
下面将原报告第 35–36 页的代码整理成完整的教学片段。它只拟合一张 32×32 的红色软光斑,不包含三维投影、多视角训练和 CUDA 光栅化,需要已有 PyTorch 环境。
1 | import torch |
这段代码的观察点是:图像位置偏差是否带来了中心梯度,形状偏差是否带来了尺度梯度,以及颜色和不透明度能否共同调整幅度。目标光斑中心为 ,初始中心位于 。
它也能说明参数不唯一的问题:在黑色背景下,单个高斯的颜色与不透明度存在乘积关系,不能仅凭拟合图像就认定每个参数都具有唯一的物理解释。
密度控制:不仅更新参数,也调整高斯数量
初始点云通常无法均匀覆盖所有细节。只移动已有高斯,可能无法填补缺失区域,也可能让一个大高斯勉强表示复杂结构。
原始 3DGS 将连续参数优化与自适应密度控制交替执行:
| 操作 | 典型触发依据 | 目的 |
|---|---|---|
| Clone | 视图空间位置梯度大,尺度较小 | 为表示不足的区域补充高斯 |
| Split | 位置梯度大,尺度较大 | 将过粗的覆盖拆成细小结构 |
| Prune | 不透明度过低,或满足异常尺度等条件 | 移除低贡献或不合适的基元 |
| Opacity reset | 按训练日程执行 | 缓解遮挡固化,配合后续优化与剪枝 |
具体阈值和执行区间属于训练配置。密度控制不是每次梯度更新都必须执行,也不是简单地“梯度大就加点”。
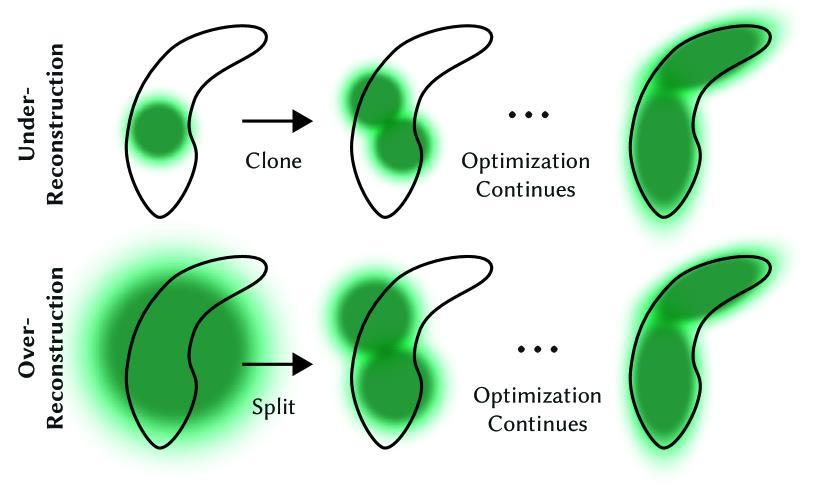
图 4:原报告第 38 页,源自 Kerbl 等人的 3DGS 项目。
为什么能够快速渲染
直接让每个高斯与每个像素比较,代价很高。快速光栅化依靠有效组织可见性和局部覆盖:
- 剔除不可见或无效的高斯。
- 将高斯投影到屏幕,计算其包围范围。
- 将屏幕划分为 Tile,找出各 Tile 可能覆盖的高斯。
- 按 Tile 与深度组织排序。
- 在 Tile 内并行执行从前到后的 Alpha Blending。
- 当剩余透射率足够低时提前停止累积。
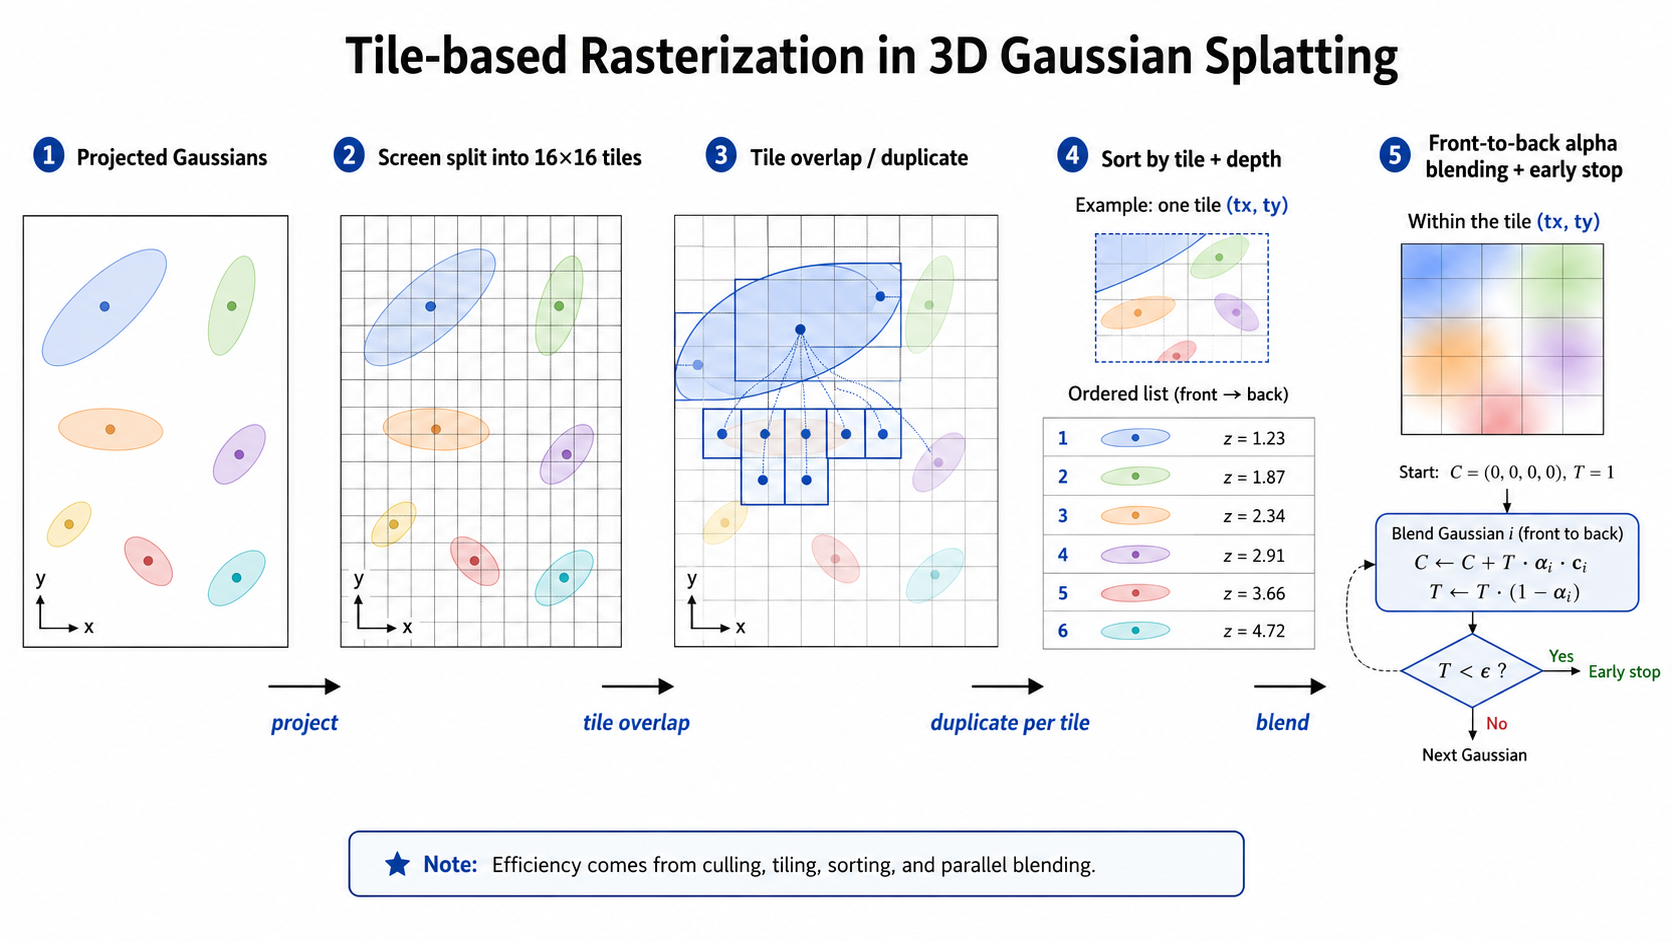
图 5:原报告第 39 页,生成式教学示意图。
因此,性能来自表示与渲染器的共同设计:软椭圆可以局部计算,Tile 限制候选集合,排序建立遮挡顺序,提前终止减少无效贡献。仅把 MLP 换成一组高斯参数,并不会自动得到高性能实现。
PLY 文件中保存的是什么
常见 3DGS PLY 包含位置、不透明度、尺度、旋转、零阶与高阶球谐系数等字段。它不是只有 XYZ 和 RGB 的普通点云。
特别要检查保存的是变换前参数还是实际值:对数尺度需要指数变换,不透明度 Logit 需要 Sigmoid,旋转四元数可能需要归一化。不同工具还可能采用不同的轴向和球谐系数排列,不能仅凭文件扩展名判断兼容性。
实验应该同时看质量、速度和代价
原论文在 Mip-NeRF360、Tanks & Temples、Deep Blending 等场景上比较图像质量与渲染速度。其强调的 1080p、至少 30 FPS 是论文硬件和设置下的结果,不是任意模型和设备的保证。原始项目及论文
| 维度 | 指标 | 阅读时需要一起确认 |
|---|---|---|
| 图像重建质量 | PSNR ↑、SSIM ↑、LPIPS ↓ | 测试视角、图像尺寸和数据划分 |
| 渲染速度 | FPS、每帧耗时 | GPU、分辨率、场景高斯数量 |
| 训练成本 | 训练时间、显存 | 迭代数、初始化、密度控制配置 |
| 表示大小 | 高斯数量、存储体积 | 是否压缩,是否保留高阶外观 |
| 几何质量 | 深度、法向、表面误差 | 是否有几何真值及额外几何监督 |
尤其要区分“图像看起来正确”和“三维表面准确”。浮点伪影、孔洞、反射表面和弱纹理区域,可能在部分视角下仍生成合理图像,却不适合直接当作干净网格使用。
原始方法还主要面向静态场景,不自带对象身份、语义类别或动态行为。这些缺口构成了后续扩展的出发点。
后续方法分别改造了哪一部分
报告后半部分的一个阅读线索是:新增的信息放在哪里,又通过什么监督或网络得到?
| 方向 | 增加或利用的信息 | 主要改造环节 |
|---|---|---|
| 几何与深度 | 深度、射线、位姿、多视角特征 | 初始化、几何预测、前馈重建 |
| 语言与语义 | 语言特征、语义特征 | 高斯属性和特征监督 |
| 对象与编辑 | 身份编码、对象分组 | 分组学习、局部修改 |
| 三维生成 | 图像生成先验、多视角条件 | 生成式优化或前馈高斯预测 |
| 在线建图 | 连续观测、相机跟踪、地图状态 | 位姿估计与地图增量更新 |
几何先验:DA3 与 DepthSplat
报告将 DA3 放在“几何入口”位置:深度、射线和位姿预测可以为后续重建提供一致的空间信息。相关模型也探索将几何能力用于高斯新视角合成。Depth Anything 3
DepthSplat 更直接连接深度估计与高斯渲染:深度帮助从图像构建高斯,渲染监督又可以用于学习更好的深度表示。这提示我们同时检查几何分支与渲染分支之间的信息流。DepthSplat
语言与对象:LangSplat 和 Gaussian Grouping
LangSplat 让高斯承载语言特征,用图像侧的语义信息学习三维语言场。查询文本与场景特征匹配后,可以定位对应对象。它还利用场景相关的低维语言空间控制显式特征的存储成本。
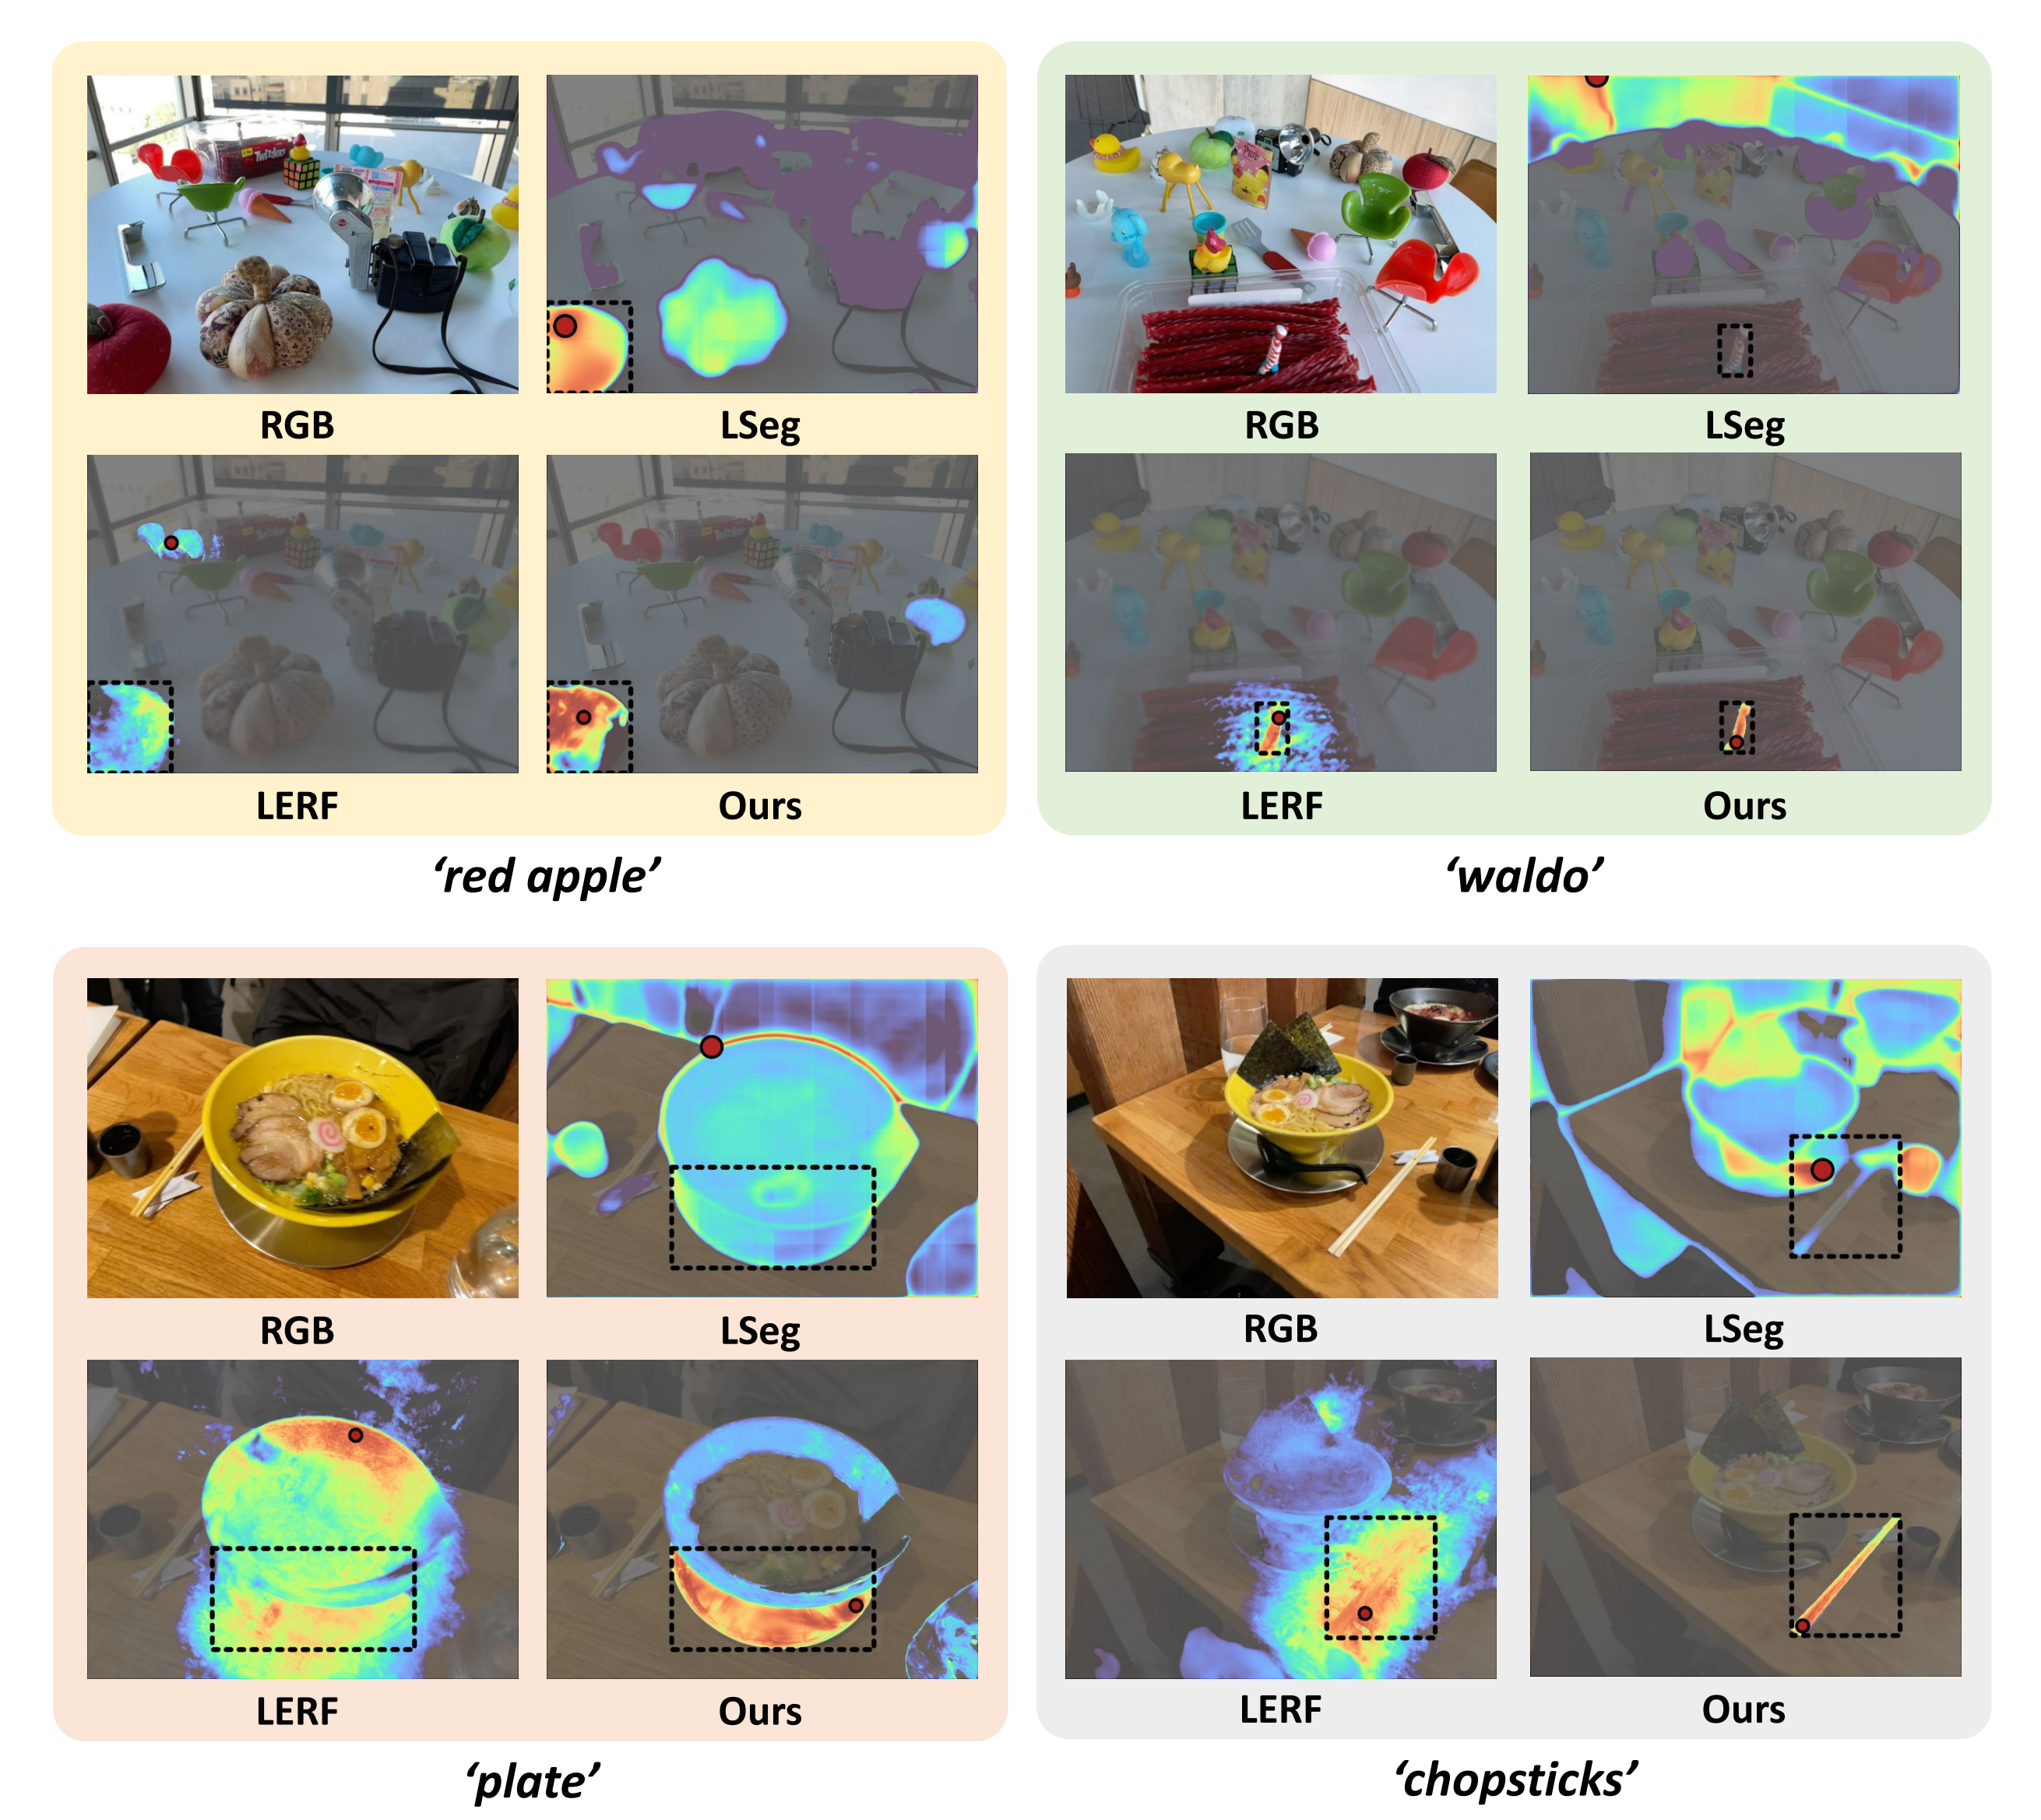
图 6:原报告第 53 页,源自 LangSplat 项目,展示的是论文方法结果。
Gaussian Grouping 为高斯增加紧凑的身份编码,用二维分割掩码和三维一致性约束形成对象分组。之后,删除一组高斯、调整其颜色或改变位置,就有了明确的对象级操作单位。
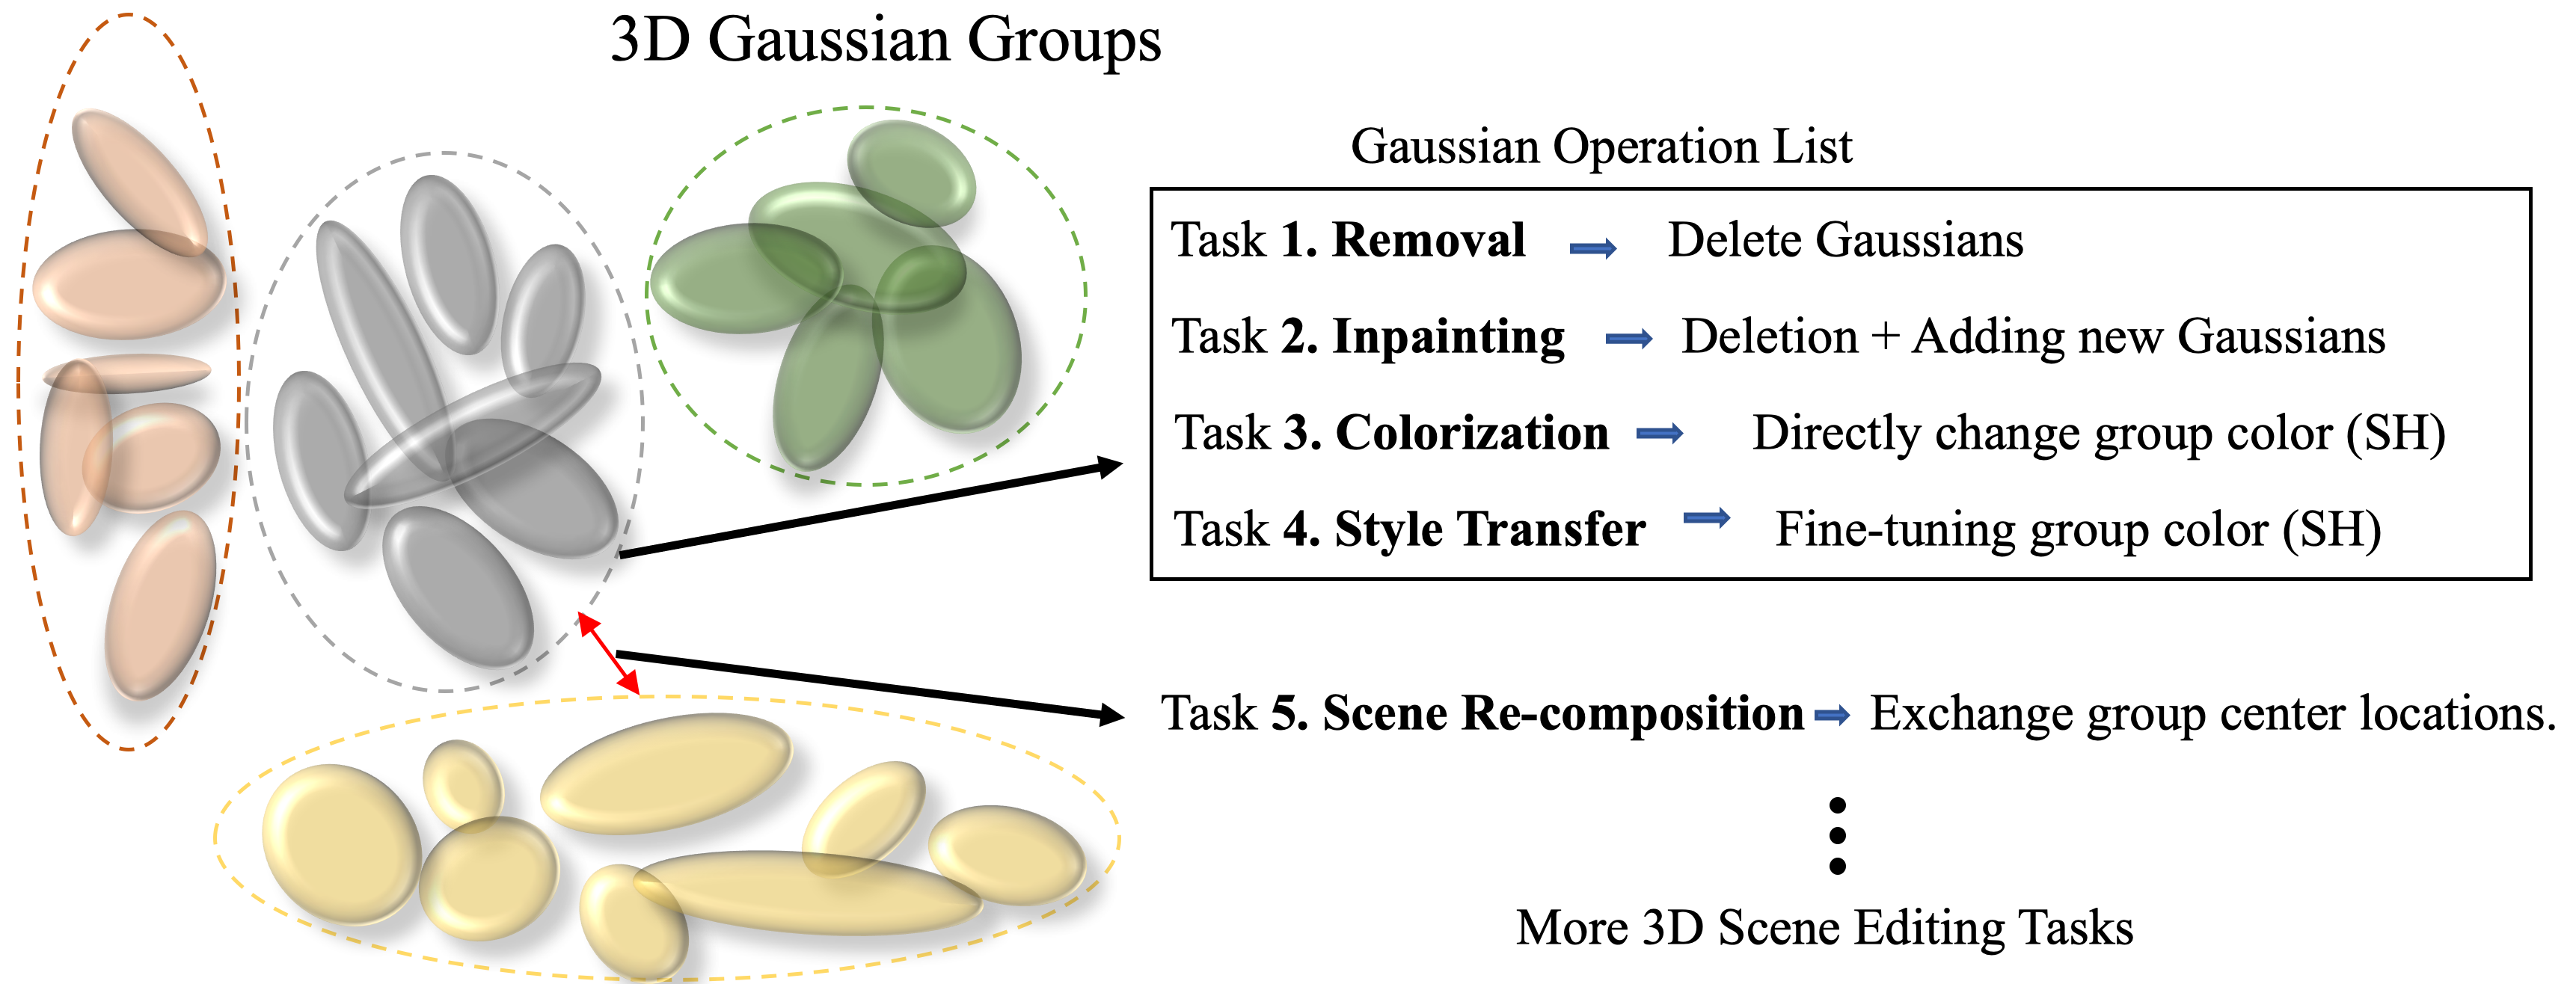
图 7:原报告第 54 页,源自 Gaussian Grouping 项目。
语言查询和对象身份不是同一件事:前者关心语义对应,后者还要处理实例区分和跨视角一致性。根据任务,有时需要同时具备二者。
三维生成:DreamGaussian 与 LGM
DreamGaussian 利用生成先验优化高斯表示,并结合网格提取和纹理细化。这里的高斯充当快速优化的中间表示,输入不再必须是一组真实拍摄、完整标定的多视角照片。DreamGaussian
LGM 则从多视角图像条件前馈预测高斯。多视角条件可以由生成模型提供,再通过高斯表示连接渲染与网格导出。
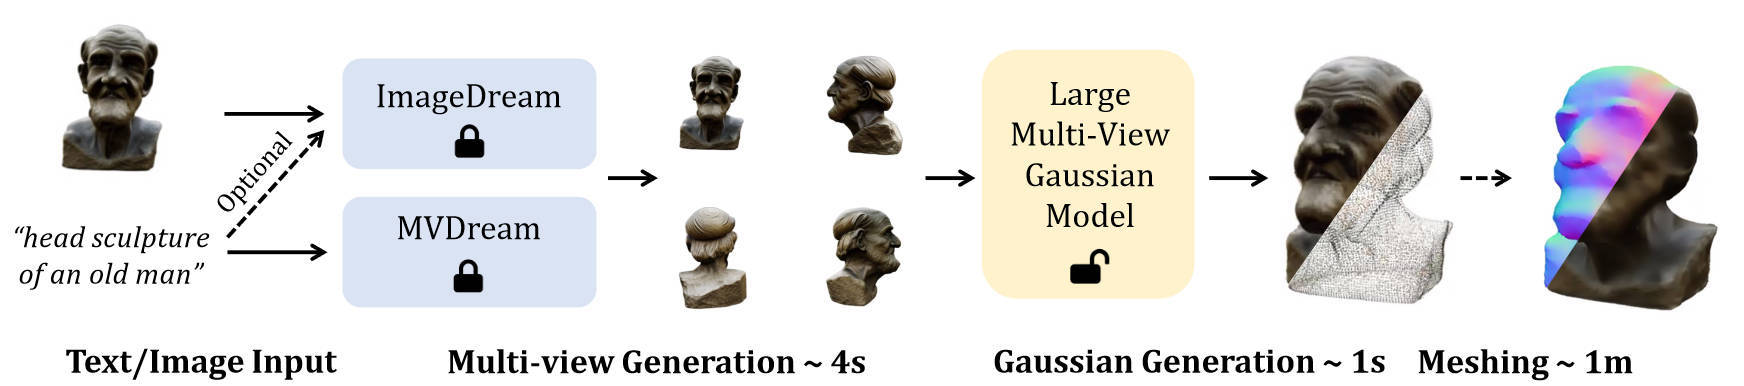
图 8:原报告第 57 页,源自 LGM 项目。图中的时间为该项目展示设置下的阶段耗时。
这两种方式分别体现了逐样本优化与前馈预测的取舍。比较速度时还需要计入输入生成、预处理和后处理,不能只截取某一个推理阶段。
在线地图:从固定场景到持续更新
报告还讨论了 Gaussian SLAM:使用可渲染高斯地图进行相机跟踪和地图更新。如果进一步学习语义属性,还能扩展为可查询的语义地图。
这里应区分基础的 Gaussian SLAM 与加入语义监督的后续方法。原报告引用的 GS-SLAM 示意用于说明高斯建图,不代表所有 Gaussian SLAM 方法都自带语义功能。在线系统还要处理累计位姿误差、动态物体和资源增长,这些不是原始离线 3DGS 单独解决的问题。
阅读新方法时可以沿着这条链路定位
这也是我整理这份报告时最有用的一条线索。先定位方法改变了哪一环,再判断它新增了什么能力,最后检查相应实验是否真的测量了那种能力。例如,语义方法需要查询或分割评估,几何方法需要表面或深度评估,不能全部用新视角图像的 PSNR 代替。
原始报告与参考资料
| 本文主题 | 原报告页码 |
|---|---|
| 任务、相机与渲染背景 | 3–19 |
| 高斯参数、协方差、投影与混合 | 20–31 |
| 反向优化、二维代码、密度控制、光栅化 | 32–40 |
| 公式总览、实验与局限 | 41–45 |
| 几何、语义、编辑、生成与建图 | 46–69 |
| 概率密度及渲染背景补充 | 70–86 |
正文保留了报告中的关键教学图和项目图,出处标在图下;重复的演示截图及口头提示没有逐页搬入。补充页的概率密度内容已并入高斯权重一节,Point-NeRF 与 Plenoxels 等背景可结合原报告继续阅读。
- Kerbl et al., 3D Gaussian Splatting for Real-Time Radiance Field Rendering · 官方项目
- Lei Mao, Camera Intrinsics and Extrinsics
- PyTorch3D, Cameras
- Hugging Face, Introduction to 3D Gaussian Splatting
- Shi Yan, How to Render a Single Gaussian Splat
- Gaussian Splatting Notes
- Awesome 3D Gaussian Splatting Applications